- 中等
- Redis
推荐答案
回答重点
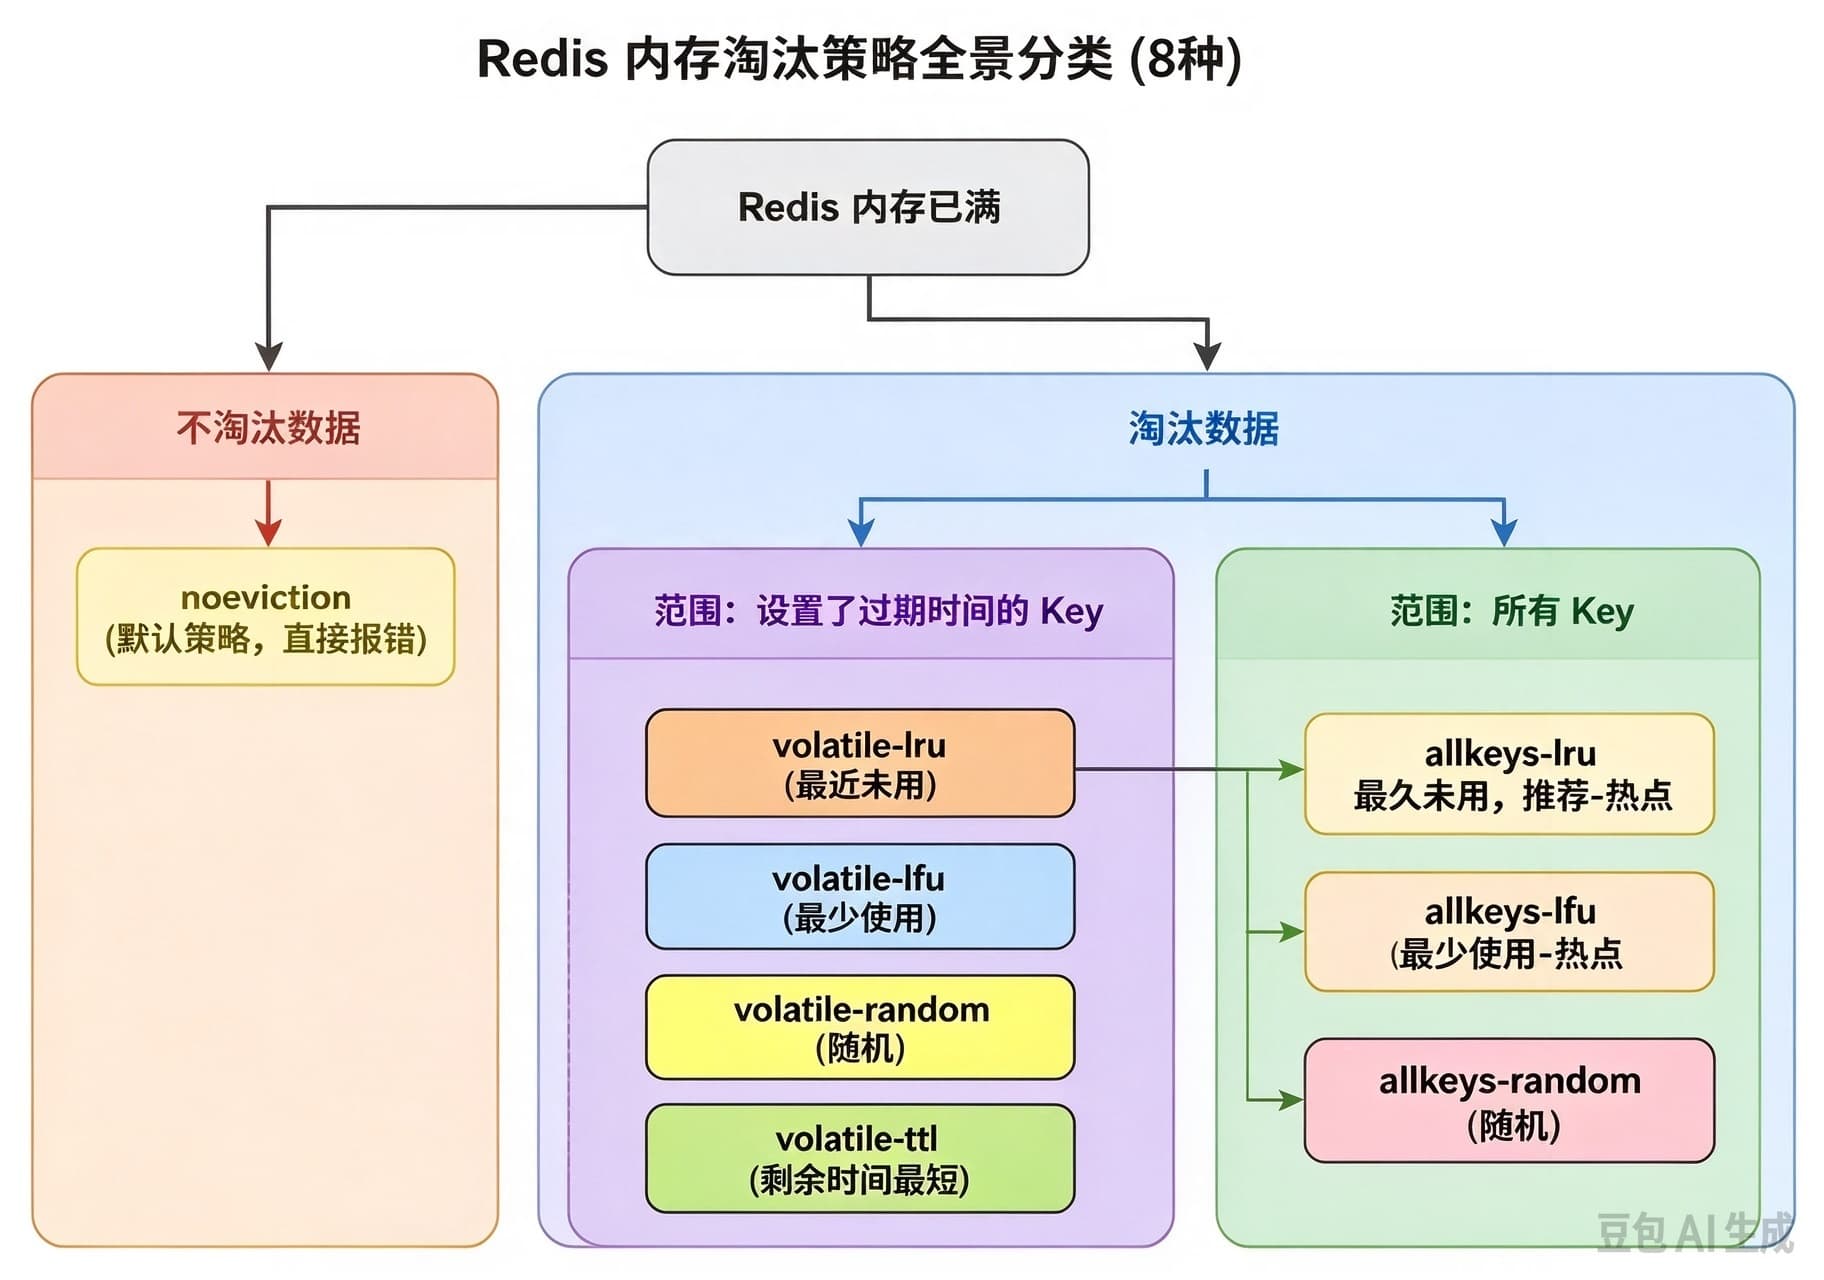
Redis 内存淘汰策略一共 8 种,分成两大类:不淘汰数据和淘汰数据。淘汰数据又能细分成针对设了过期时间的 key 和针对所有 key 两种。
不淘汰数据:
- noeviction:内存满了直接报错,禁止写入,Redis 默认就是这个策略
针对设了过期时间的 key 淘汰:
- volatile-random:随机干掉设了过期时间的 key
- volatile-ttl:优先干掉剩余存活时间最短的 key
- volatile-lru:淘汰最久没被访问的 key
- volatile-lfu:淘汰访问频率最低的 key,Redis 4.0 新增
针对所有 key 淘汰:
- allkeys-random:随机干掉任意 key
- allkeys-lru:淘汰最久没被访问的 key
- allkeys-lfu:淘汰访问频率最低的 key,Redis 4.0 新增
扩展知识
LRU vs LFU 的选择
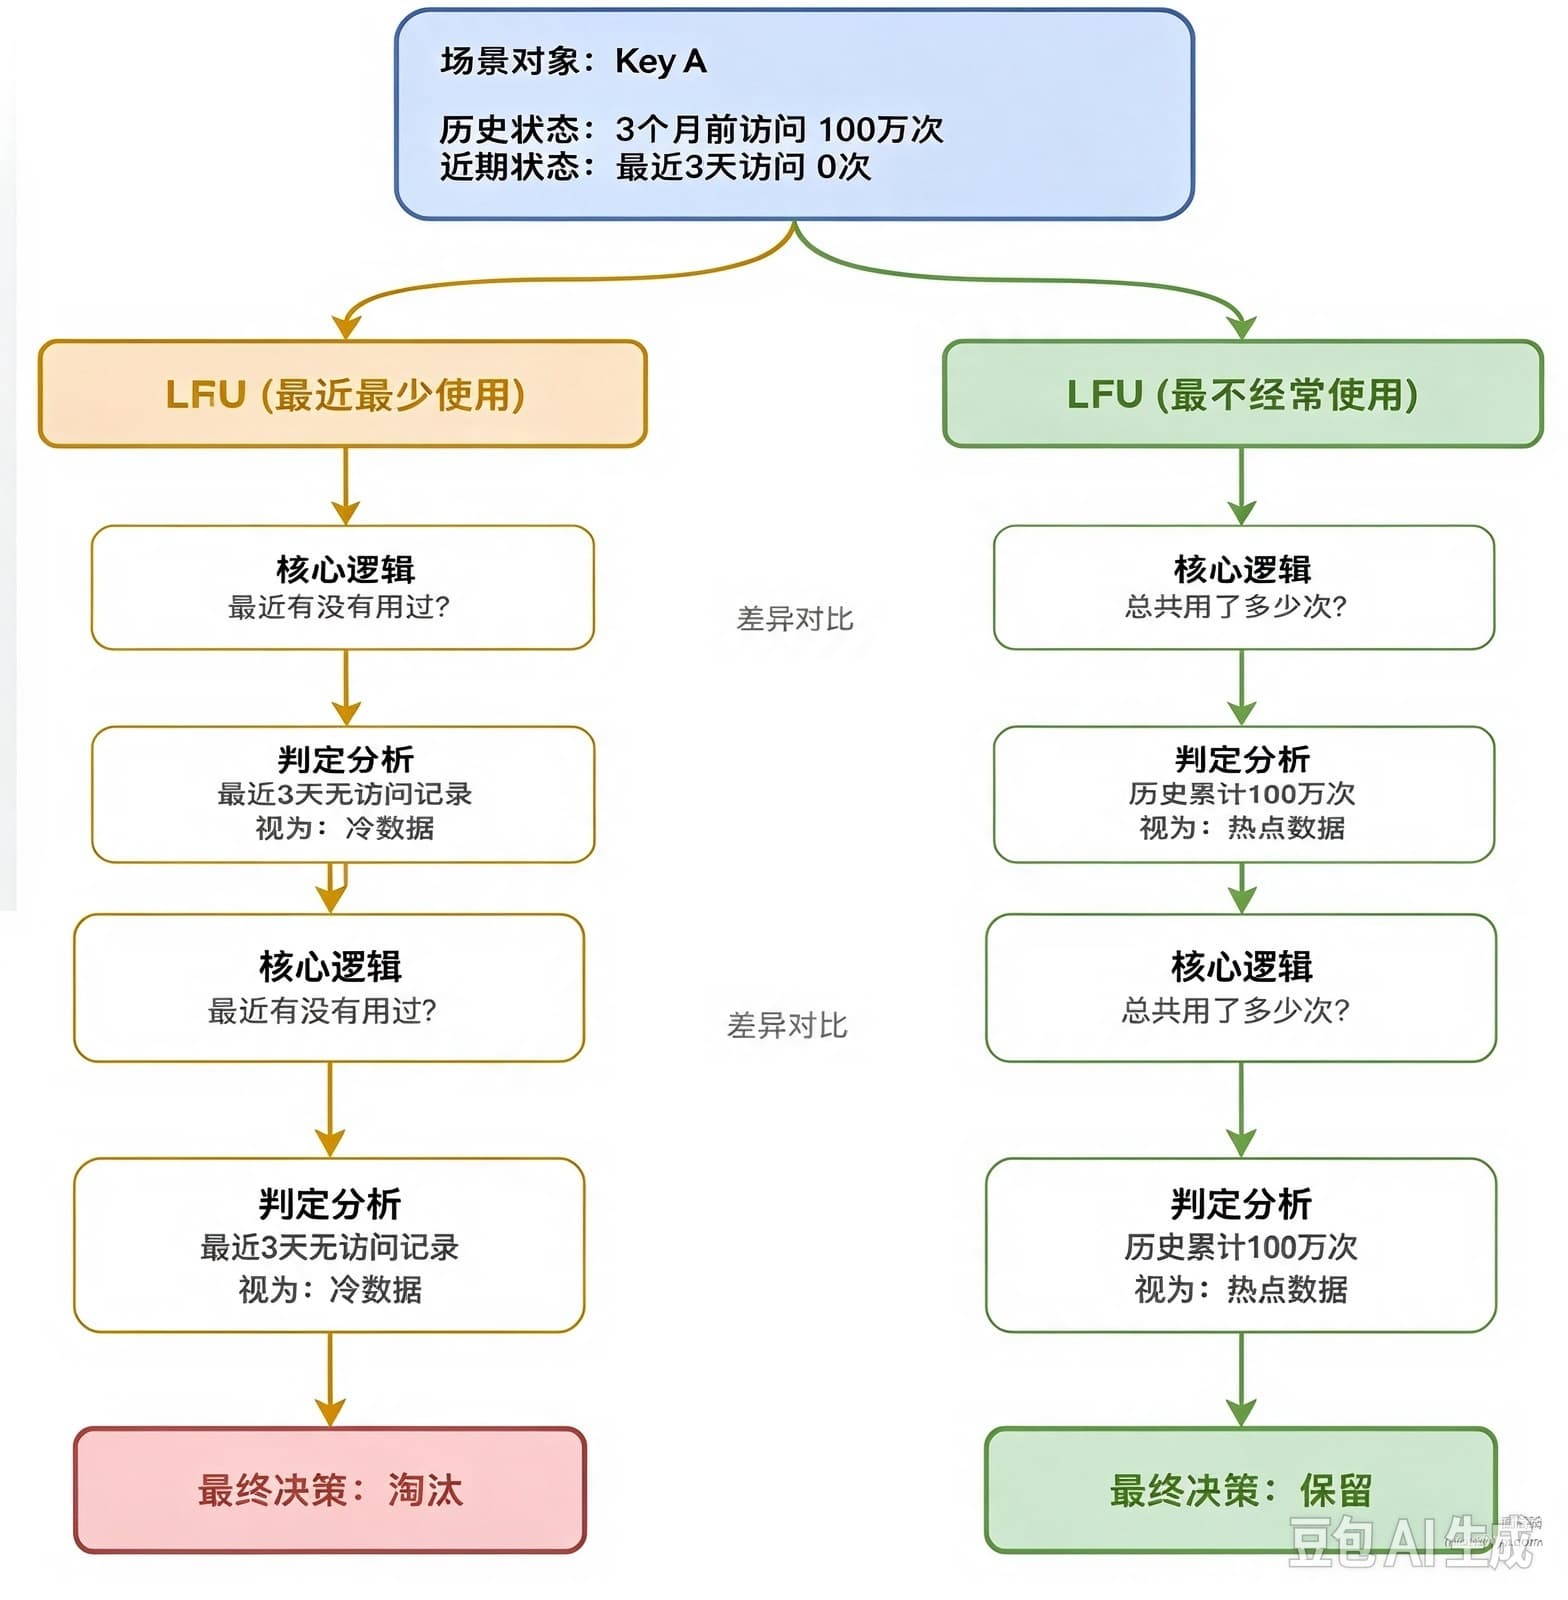
LRU 适合访问模式比较平稳的场景,比如普通的缓存服务。但 LRU 有个问题:如果某段时间有大量冷数据被批量扫描,会把真正的热数据挤出去。
LFU 就是为了解决这个问题,它统计访问频率而不是访问时间。但 LFU 也有坑:如果某个 key 历史上被访问很多次,但现在已经不热了,它还是会一直占着内存。Redis 4.0 引入的 LFU 算法做了优化,访问计数会随时间衰减,不会出现"僵尸热点"的情况。
实际生产环境怎么选
- 大多数业务场景直接用 allkeys-lru 就行,简单粗暴又有效
- 如果业务有明确的热点数据,比如电商的爆款商品、社交平台的热门帖子,用 allkeys-lfu 更合适
- 如果 Redis 里存的数据分两类,一类是缓存数据设了过期时间,另一类是持久化数据没设过期时间,那就用 volatile-lru,这样只淘汰缓存数据,持久化数据不会被误删
- noeviction 一般用在 Redis 当消息队列的场景,数据丢了可能造成业务异常,宁可写入失败也不能丢数据
内存淘汰配置方式
两种方式设置淘汰策略:
- 改配置文件 redis.conf,重启生效,重启后不丢失:
maxmemory-policy allkeys-lru
- 命令动态设置,立即生效,但重启就没了:
CONFIG SET maxmemory-policy allkeys-lru
还有个参数 maxmemory-samples 也很重要,Redis 的 LRU/LFU 并不是精确算法,而是采样近似。默认采样 5 个 key,从中选一个淘汰。把这个值调大能提高淘汰精度,但会增加 CPU 开销。一般 5-10 就够用了。
内存满了会发生什么
配置了 noeviction 策略时,内存满了 Redis 不会崩,已有数据照样能读能删,只是新数据写不进去。这时候执行 SET、LPUSH 这类写命令会返回 OOM 错误:
(error) OOM command not allowed when used memory > 'maxmemory'
另外,64 位系统如果不设 maxmemory 或者设成 0,Redis 不限制内存使用,能用多少取决于物理内存。32 位系统最多用 3GB。
面试官追问
提问:Redis 的 LRU 是精确的 LRU 算法吗?如果不是,为什么要这么设计?
回答:不是精确 LRU,是近似 LRU。精确 LRU 需要维护一个全局的访问时间链表,每次访问都要更新链表,这个开销太大了。Redis 选择采样近似,每次淘汰时随机抽 5 个 key,从中挑最老的那个干掉。这样只需要在每个 key 上记一个最后访问时间戳,不用维护全局链表。根据 Redis 官方测试,采样 10 个 key 的近似 LRU 效果已经非常接近精确 LRU 了。
提问:volatile 开头的策略和 allkeys 开头的策略有什么本质区别?
回答:区别在于淘汰范围不同。volatile 系列只在设了过期时间的 key 里面选,allkeys 系列在所有 key 里面选。如果你的 Redis 里没有任何 key 设置了过期时间,用 volatile 系列策略等于没设,内存满了还是会报 OOM。所以生产环境如果用 volatile 策略,一定要确保业务上确实有大量 key 设置了过期时间。
提问:LFU 算法里的访问频率是怎么统计的?会不会无限增长?
回答:Redis 用一个 8 位的计数器记录访问频率,最大值就是 255。但这个计数器不是每次访问都加 1,而是用概率递增:计数值越大,递增概率越低。同时这个计数值会随时间衰减,衰减速度可以通过 lfu-decay-time 参数控制。这样既防止了计数无限增长,又避免了历史热点数据长期霸占内存的问题。